Por que a tradução ao vivo não consegue acompanhar os cânticos de louvor
A demo parece bem durante a recepção. As legendas chegam. O áudio em espanhol fica um pensamento atrás do pastor, como a tradução ao vivo sempre faz. Então a banda começa. O telefone se enche de fragmentos, meias palavras e uma linha que não está na música. Alguém da equipe técnica silencia a sessão. Os presbíteros concluem que a tradução ao vivo não funciona.
Ela fez o trabalho para o qual foi feita. O louvor cantado é outro trabalho.
Isto não é um tutorial de configuração. É a pergunta de avaliação que as igrejas encontram na primeira vez que testam um tradutor de fala num domingo com um set de louvor: se a camada do sermão é usável, por que a mesma ferramenta desmorona quando as pessoas cantam?
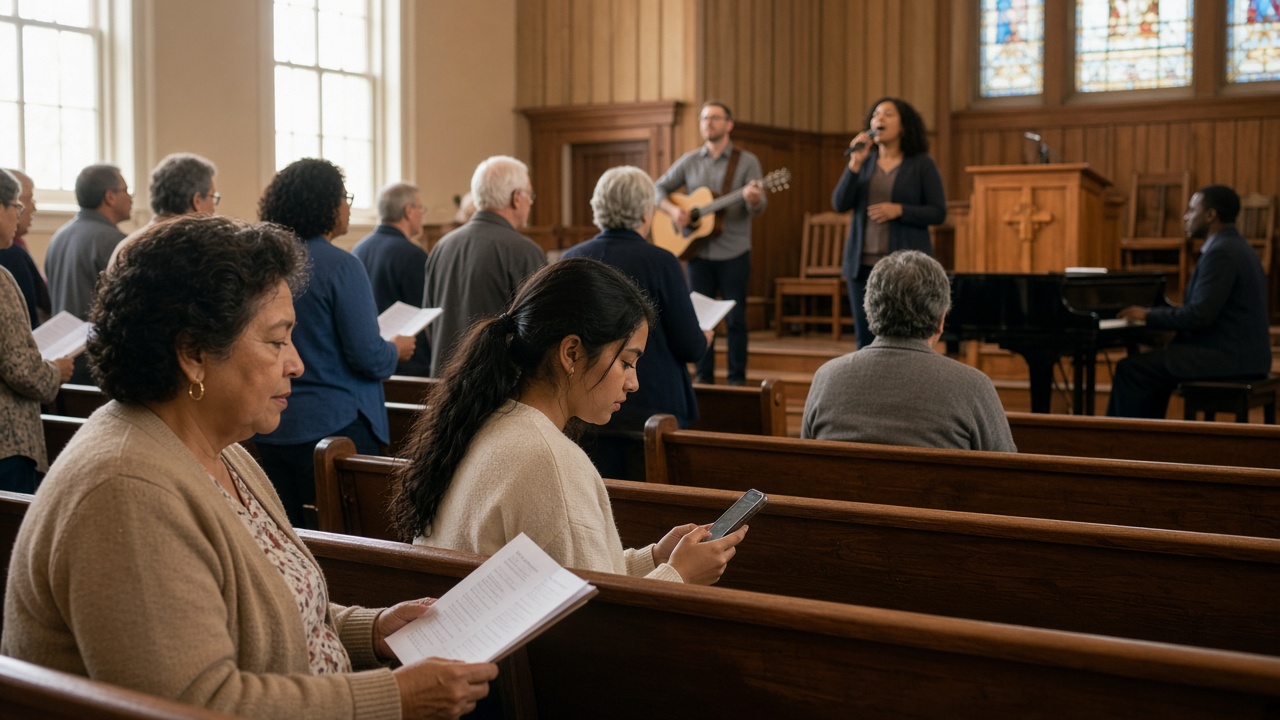
O reconhecimento de fala é treinado para conversa
A tradução ao vivo com IA é uma cadeia, não um músico.
- O reconhecimento de fala transforma o áudio em texto no idioma de quem fala.
- A tradução automática transforma esse texto no idioma de quem ouve.
- A síntese de voz opcional lê a linha em voz alta.
Se a etapa 1 nunca ouve uma frase, a etapa 2 não consegue recuperar uma letra. A precisão em 2026 é mais forte com uma voz clara e linguagem falada contínua: um sermão, uma leitura, uma palestra. Os modelos de reconhecimento são treinados nesse tipo de áudio—consoantes, pausas, ritmo de conversa, uma boca perto do microfone.
Cantar é outro objeto acústico. As vogais se esticam. A altura substitui os contornos da fala que o modelo espera. As harmonias se empilham. A mesma palavra pode durar dois compassos. Um reconhecedor excelente no microfone do púlpito ainda vai chutar quando a entrada é uma melodia.
Por isso um mix-minus, um sinal só de fala ajuda o sermão e ainda assim não faz um hino se comportar como um parágrafo. Isolar o canal vocal tira bateria e pads. Não transforma canto em fala.
A sala está escrevendo várias faixas ao mesmo tempo
Um set típico de domingo é polifônico de propósito.
O líder de louvor está no microfone de mão. Pads e violão sustentam a melodia. A congregação canta meio tempo atrás, ou à frente, ou noutra tonalidade. Alguém murmura. Uma criança fala no corredor. Se o sinal é a mixagem da casa, pede-se ao modelo que transcreva um coro, uma banda e um recinto.
Mesmo um envio vocal limpo ainda é uma pessoa cantando, muitas vezes com faixas empilhadas ou um click que vaza dos monitores intra-auriculares. O canto congregacional é o caso mais difícil: muitas bocas, nenhum ataque único, nenhuma altura única. O ouvido humano trata isso como louvor. Um modelo de fala trata como falantes sobrepostos—o mesmo modo de falha que aparece em mesas barulhentas.
Isto não é um capricho do Hope Tradutor. É assim que sistemas de fala ao vivo funcionam. Ferramentas que afirmam “traduzir as músicas” em geral chutam fragmentos ou deixam a música passar sem traduzir. As duas coisas podem ser honestas de modos diferentes. Fingir que uma legenda embaralhada é um hino bilíngue não é.
Letras não são frases
Mesmo quando uma linha é ouvida, o texto de uma canção é uma entrada ruim para tradução automática.
Sermões falados costumam correr em prosa: sujeitos, verbos, um ponto que pousa no fim do parágrafo. Letras comprimem. Invertem a gramática para fechar uma rima. Repetem um refrão que significa mais na terceira vez por causa da música por baixo. Carregam teologia em metáfora—“oceano”, “fogo”, “véu”—que um tradutor de fala renderiza como substantivos comuns.
Quem traduz canções à mão exerce outro ofício. Mantém metro, cantabilidade e a doutrina que o original realmente ensina. Decide se um hino conhecido deve aparecer na versão que a sala já canta. Uma cadeia de fala ao vivo não faz esse trabalho em poucos segundos. Só pode passar o texto captado para outro idioma, sem melodia a servir e sem hinário a consultar.
Dois erros então se empilham. A transcrição do canto já está incompleta. A tradução dessa linha incompleta é um segundo palpite. O convidado lê uma legenda que não é a letra nem o sentido, e conclui que toda a camada é pouco confiável.
Um sinal quebrado de música ensina a lição errada
O custo não é só um telefone bagunçado na segunda estrofe.
Os convidados perdem o sermão que estavam prestes a receber. Se os primeiros dez minutos de legendas foram um disparate, as pessoas guardam o telefone antes da mensagem. A camada que os teria ajudado a acompanhar a pregação nunca ganha um minuto justo.
A equipe decide que o produto falhou. Uma demo de domingo que inclui o set inteiro é um teste duro da função errada. O teste justo é a hora falada: recepção, Escritura, sermão, avisos, convite. Julguem isso. Se dá para acompanhar, a ferramenta fez o trabalho.
A igreja continua pedindo que o software seja uma equipe de louvor. Cantar na língua do coração é ministério, não um ajuste de legenda. Uma congregação que canta em espanhol é um modelo diferente de uma hora em inglês com uma camada no telefone. Essa decisão pertence a culto em espanhol vs tradução ao vivo, não a um teste de software.
O que de fato ajuda as pessoas a cantar noutro idioma
Ajustem a ferramenta ao trabalho.
Ponham as palavras numa página ou num slide. Muitos hinos e canções modernas já existem em espanhol, coreano, português, mandarim e noutros idiomas que a sala realmente usa. Uma letra bilíngue impressa, uma segunda estrofe projetada ou um encarte no boletim fazem mais pelo louvor cantado do que um palpite ao vivo. A Noite de Natal é a versão extrema—luz de velas, vozes sobrepostas, cânticos que quase todos conhecem. A mesma lógica está em como tornar a Noite de Natal multilíngue: liturgia cantada quer uma página.
Traduzam as músicas que vocês já sabem que vão cantar. A setlist não é surpresa. Se no domingo há quatro músicas, alguém pode preparar na quinta traduções publicadas para as quais vocês já têm direitos—ou uma pessoa bilíngue pode conferi-las. Isso é trabalho editorial. Não é fala ao vivo.
Não gastem cota num set de louvor. O Hope Tradutor é feito para conteúdo falado. Se a mesa puder enviar um sinal só de fala, as músicas nunca chegam ao tradutor. Se usam um microfone de sala ou a mixagem completa, parem a tradução quando o canto começa e reiniciem quando alguém fala. O canal de transmissão pode ficar aberto para o QR code não mudar. Vocês também evitam usar horas em áudio que o modelo não consegue aproveitar.
Digam o plano em voz alta. Os convidados não deveriam inventar uma explicação para um telefone quieto na terceira música. Uma frase basta: a camada é para as partes faladas; a letra está na tela e na folha.
Usem a tradução ao vivo para a hora que é falada
A hora pública ainda vale a pena ser acompanhável. As pessoas decidem se voltam durante a recepção, a leitura, a mensagem e o convite ao próximo passo—não durante um refrão que de qualquer forma não conseguiram cantar.
O Hope Tradutor é feito para transcrição e tradução ao vivo da fala—na web e nos aplicativos móveis—com modos transmissão (uma voz, muitos ouvintes) e solo / conversa (um a um). Uma pessoa da recepção ou um voluntário técnico pode ser anfitrião. Os convidados entram com um QR code ou um link, escolhem um idioma e leem legendas ou ouvem uma voz de IA. Eles não criam uma conta.
Essa é a ferramenta certa para a tradução de sermões ao vivo e para o andaime ao redor. É a ferramenta errada para um hino. Igrejas que separam esses trabalhos ganham uma demo mais limpa, uma promessa mais honesta e um convidado que ainda tem o telefone na mão quando o pastor começa a pregar.
Se quiserem ouvir a diferença, façam um teste curto com um sermão gravado e com um set de louvor gravado. Julguem o sermão. Imprimam as músicas.
Prontos para tornar a hora falada acompanhável? Comecem uma sessão em hopetranslator.com ou comparem os planos em pricing.