Qué decirles a los oradores cuando tu evento tiene traducción en vivo
El ensayo se veía bien. Llegaron los subtítulos. El audio en español iba un pensamiento detrás de la keynote, como siempre hace la traducción en vivo. Entonces se abrieron las puertas.
La oradora caminó hacia la pared de diapositivas con el clicker. Las preguntas del piso nunca llegaron a un micrófono. Un video de producto sonó por los altavoces de sala y nunca entró al feed de traducción. Quienes habían escaneado un código en el registro se sentaron una hora en inglés con el teléfono en silencio. Producción culpó a la herramienta.
La herramienta hizo el trabajo que le dieron. A la oradora nadie le dijo que había un segundo público.
Esto es un brief para oradores, no un tutorial de configuración. Las cabinas humanas y las capas de IA fallan en los mismos sitios: una boca que deja el micrófono, un guion que corre, un panel que habla encima de sí mismo. Si todavía estás eligiendo si traducir el resto del día, empieza por lo que los asistentes pierden cuando solo se traduce la keynote. La pregunta aquí es qué poner en la nota de una página que envías a cada ponente.
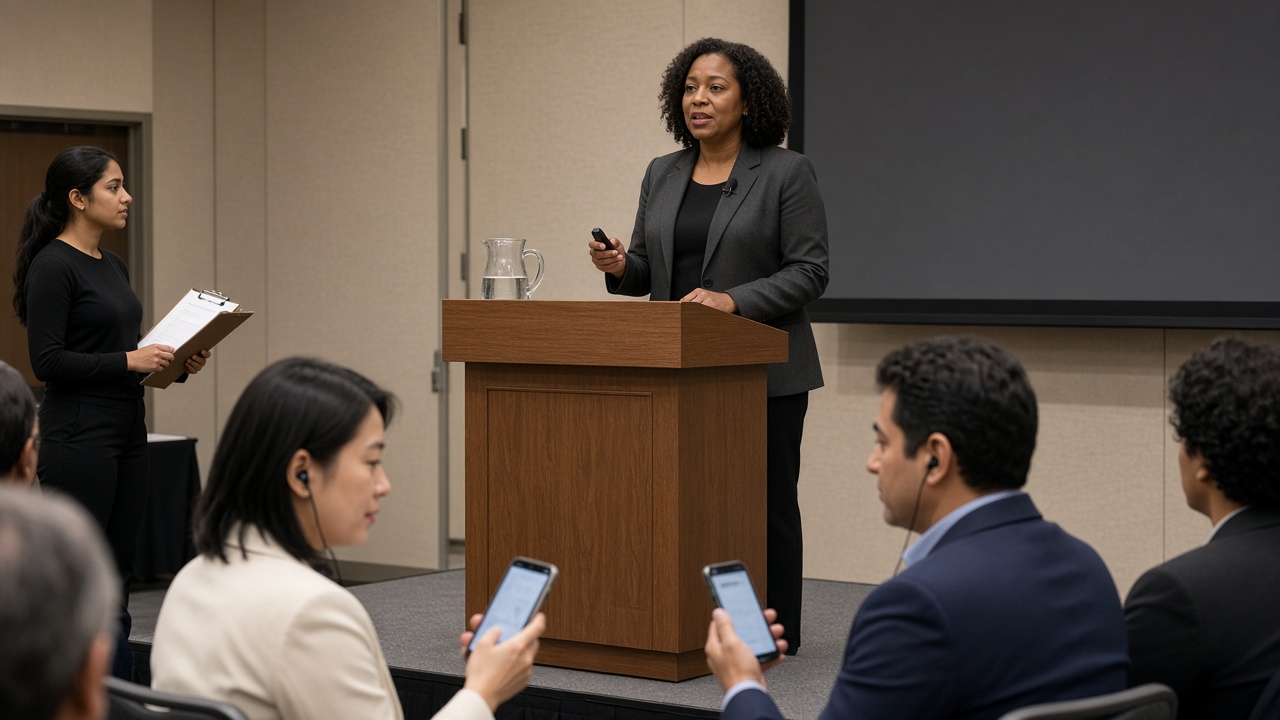
1. Diles que parte de la sala no está oyendo su voz
La mayoría de los oradores se preparan para las caras que pueden ver. No para las personas en un segundo canal—una intérprete en cabina, una voluntaria con un receptor FM o un teléfono en la tercera fila.
Eso no es motivo para señalar a nadie desde el escenario. “Los que están usando traducción” convierte el acceso en un foco. Una frase en el brief basta: esta sesión se está interpretando o traduciendo en vivo. Quédate en el micrófono. No esperes una segunda voz después de cada frase.
La última cláusula importa. Pedirle a una keynote que pause después de cada párrafo convierte el trabajo simultáneo en consecutivo y duplica la hora. El brief debe proteger la duración original y a las personas que van unos segundos detrás.
Imagina una cumbre regional—un ejemplo, no una historia de cliente. La presentadora ya sabe que hay un canal en español. La analista invitada no. Trata el micrófono del atril como opcional en cuanto tiene el clicker. Quienes más necesitaban su charla son quienes la pierden primero.
2. Si no está en el micrófono, no existe
La Asociación Internacional de Intérpretes de Conferencias es clara con los oradores: sin micrófono, las intérpretes no pueden oírte, por muy alto que hables. La traducción en vivo con IA tiene el mismo oído. El reconocimiento solo es tan bueno como el feed de voz.
Las fugas habituales no son un misterio.
- Caminar para señalar una diapositiva
- Girarse hacia otra persona del panel y bajar el volumen
- Responder una pregunta del pasillo desde el frente del escenario
- Probar el micrófono tocándolo en vez de decir una frase
Si se mueven, necesitan un lavalier. Si se quedan en el atril, igual tienen que hablar hacia él cuando miran la pantalla. Golpear la cápsula para “probarla” solo explota a quien escucha ese canal. Di “buenos días.” Luego empieza.
Esta es la versión para oradores de un feed de mesa de mezclas solo de voz. Producción puede aislar el canal vocal. Producción no puede recuperar una frase que nunca se habló al micrófono.
3. Leer es más rápido que hablar—y ese es el fallo habitual
Una keynote conversada suele ir bien. Un guion, no.
La gente acelera cuando lee. Las intérpretes lo dicen desde hace décadas. La guía de AIIC para oradores es lo bastante concreta para un correo: reserva unos tres minutos por página de 40 líneas si lees, y ensaya el ritmo de antemano si no has hablado con interpretación. El público de la lengua de sala también pierde el hilo cuando alguien corre. El segundo canal solo lo pierde antes.
No hace falta aplanar la charla. Hace falta terminar un pensamiento. Nombres, un giro en una historia, un número en una diapositiva—eso necesita un pulso después de la frase, no una parada antes de cada frase.
Si una demo “falla” solo con diapositivas densas, el retraso no es el error. Cronometra la página más densa. Si no cabe, recorta la página, no los idiomas.
4. Nombres, acrónimos y números reciben un pase completo
La primera vez que aparece un nombre de producto, un ministerio o una agencia, dilo completo. Luego puede aterrizar la forma corta.
Una intérprete humana que recibió el mazo de diapositivas el jueves puede recuperar “NPS” como Net Promoter Score. Un sistema que solo oye “en-pee-ess” tiene una oportunidad. No hace falta un guion pulido. Una lista de oradores con pronunciaciones, un mazo en borrador y las expansiones de los cinco términos de cada diapositiva bastan. Las cabinas humanas necesitan ese material para prepararse. Una capa de IA igualmente se beneficia cuando la boca dice la expansión una vez, al micrófono.
Las cifras son el mismo trabajo. “Quince” y “cincuenta” se parecen en un salón ruidoso. Di el número, luego mira el gráfico. No asumas que quienes llevan auriculares vieron la diapositiva.
5. Videos, apariciones y invitados remotos son oradores extra
Un clip grabado en la mezcla de sala no entra automáticamente a la sesión de traducción. Una fundadora por el altavoz de un portátil no entra automáticamente al feed del atril. Una aparición sorpresa con un micrófono de mano es una boca nueva.
Pide a los oradores que señalen cada voz que no es la suya: un video de producto, una panelista remota, una copresentadora que toma los últimos diez minutos. Producción puede entonces decidir si ese audio tiene camino a la sesión. Si no, dilo. “Los próximos dos minutos son un film de marca solo en inglés” es mejor que un canal muerto que parece un fallo.
Los oradores remotos necesitan el mismo brief con un micrófono más estricto: un auricular de verdad, no la cavidad del portátil; un solo micrófono abierto; una prueba de sonido desde la sala que realmente usarán.
6. Los paneles mueren cuando hablan dos personas
Una keynote es una boca. Un panel es un atasco.
El habla superpuesta es cómo el turno de preguntas se convierte en la primera hora sin traducir de un programa por lo demás cuidadoso. Dos panelistas se terminan las frases. Una pregunta llega del piso sin micrófono. La moderación resume en la lengua de sala y sigue. Quien está en un canal de traducción oye un borroso, o no oye nada.
El brief de un panel es más corto que el de una keynote, y más estricto.
- Un micrófono abierto
- La moderación repite cada pregunta del piso en ese micrófono antes de que alguien responda
- La gente termina una frase antes de que empiece la siguiente persona
- Los chistes que dependen de hablar encima no viajan
Esa es la correspondencia de producción con el problema de los asistentes: el Q&A es donde la gente deja de ser público. Si la parte interesante de la hora es la discusión, la discusión tiene que ser tan seguible como las palabras de apertura.
Un pastor que deja el púlpito para recoger peticiones de oración en el pasillo corre el mismo patrón. El micrófono de mano tiene que viajar con la conversación, o la capa se queda en el púlpito vacío.
7. Unos segundos de retraso son el sistema funcionando
Los oradores que nunca han sido interpretados a menudo intentan “ayudar” esperando. Terminan una frase, miran un tablero de subtítulos y se detienen hasta que aparece el otro idioma. Eso entrena a la sala a tratar la traducción como una segunda actuación. También hace imposible un hueco de 25 minutos.
La instrucción útil es lo contrario de congelar-y-esperar. Sí pausa después de un punto denso para que el segundo canal termine el pensamiento. No esperes subtítulos después de cada cláusula. Sí asume que alguien en la sala va unos segundos detrás. No te gires a leer el teléfono de la tercera fila.
Un retraso breve es cómo tanto la interpretación simultánea humana como la traducción en vivo con IA protegen el sentido. Una salida palabra por palabra instantánea sería más rápida y peor. Pon una frase de eso en la nota al orador para que no concluya, a mitad de la keynote, que el sistema está roto. La evaluación más larga está en por qué la traducción en vivo tiene retraso.
Lo que este brief no es
No es una petición de aplanar el humor, la teología o la profundidad técnica. No es un sustituto de una persona cualificada cuando un matiz perdido es legal, médico, diplomático o pastoral. La consejería, las entrevistas de membresía y las negociaciones de contrato siguen necesitando a una persona. Si estás sopesando una voz humana frente a una capa para una hora concreta, empieza por traducción en vivo vs intérprete humano.
Tampoco es un tutorial de software. No hay que pedirle a los oradores que alojen la sesión, compartan un código QR o arreglen el Wi-Fi. Eso es trabajo del equipo del evento. El trabajo del orador es hablar a un micrófono a un ritmo que un segundo público pueda usar.
Las iglesias pueden enviar la misma nota en seis líneas: quédate en el micrófono, no corras el manuscrito, repite los anuncios, deja que otra persona lleve el código en la puerta. Los equipos de conferencia pueden pegar los siete puntos en el portal de oradores junto al rider de AV. En ambos casos, envíalo antes del ensayo, no durante la disculpa.
Dónde encaja la traducción en vivo después del brief
La traducción en vivo es la capa que hace seguible una hora hablada. No reemplaza a un orador que deja el micrófono, y no recupera un video que nunca entró al feed.
Hope Traductor está pensado para transcripción y traducción en vivo del habla—en la web y en las apps móviles—con modos broadcast (una persona habla, muchas escuchan) y solo / conversación (uno a uno). Una persona de escenario o voluntaria puede ser anfitriona. Los asistentes escanean un código QR o abren un enlace, eligen un idioma y leen subtítulos, escuchan una voz de IA, o ambas cosas. No crean una cuenta.
Esa es la herramienta correcta cuando las personas que necesitan otro idioma ya están en una sala que tú diriges: una keynote, un breakout, un sermón de domingo, un panel con un feed claro. Usa broadcast para esas salas. Usa el modo conversación para la pregunta del pasillo después de la sesión. Usa a una persona cualificada para las conversaciones que nunca debieron ir a una capa de subtítulos.
Para el modelo más amplio del evento, ver traducción en vivo para eventos. El brief de arriba es la capa de oradores de ese modelo. Confirma los planes actuales en precios.
Envía la nota antes del clicker
Recorre las grabaciones del año pasado como oyente que no piensa en la lengua de sala. ¿El orador se quedó en el micrófono? ¿Se repitieron las preguntas del piso? ¿Alguien le dijo a la ponente que el retraso es normal?
Si las respuestas honestas son no, no tuviste un problema de traducción. Tuviste un orador sin brief. Pon los siete puntos en el portal. Luego sigue haciendo el trabajo que el software no puede: una moderación que repite la pregunta, un micrófono de mano que sigue el pasillo, y una anfitriona que arranca la sesión antes de la primera palabra.
¿Listo para una sesión que tus oradores puedan sostener de verdad? Empieza en hopetranslator.com o compara planes en precios.